Mục lục · 6 phần
Trả lời nhanh
Inference là quá trình AI nhận yêu cầu, xử lý dữ liệu đầu vào và dùng những gì đã học để tạo kết quả. Câu lệnh của anh/chị được chuyển thành token, các mảnh dữ liệu mà mô hình đọc để nắm bối cảnh. Khi viết câu trả lời, mô hình dự đoán phần tiếp theo dựa trên đầu vào và phần vừa tạo.
Inference là quá trình mô hình trí tuệ nhân tạo nhận yêu cầu của anh/chị, đọc toàn bộ dữ liệu đầu vào và suy luận để tạo ra kết quả cuối cùng. Đây là giai đoạn mô hình “đang nghĩ” và dùng những gì đã được huấn luyện để viết câu trả lời, dịch một văn bản hoặc phân tích bảng số liệu bán hàng.
Máy tính “suy nghĩ” như thế nào khi chạy AI?
Khi anh/chị gõ một câu lệnh, hệ thống sẽ chuyển toàn bộ chữ viết thành các mảnh dữ liệu nhỏ hơn gọi là token. Sau đó, quá trình inference chính thức bắt đầu. Mô hình đọc toàn bộ số token này để nắm bắt bối cảnh. Dựa trên xác suất thống kê, nó dự đoán token nào có khả năng xuất hiện cao nhất và in ra chữ đầu tiên.
Ngay sau đó, mô hình lại lấy toàn bộ câu lệnh ban đầu cộng thêm chữ vừa tạo ra để tiếp tục suy luận chữ thứ hai. Quá trình lấy đầu ra làm đầu vào này lặp lại liên tục hàng nghìn vòng cho đến khi hoàn thành xong câu trả lời. Cơ chế cuộn tròn và dự đoán liên tục này lý giải tại sao inference tiêu tốn rất nhiều sức mạnh tính toán của máy chủ. Khi anh/chị thấy màn hình hiển thị từng chữ một nhấp nháy, đó là lúc anh/chị đang chứng kiến tốc độ inference diễn ra theo thời gian thực.
Bên dưới quá trình tính toán phức tạp này, mô hình sử dụng cơ chế transformer attention để quyết định xem nó nên tập trung vào từ nào trong câu lệnh là quan trọng nhất. Nhờ vậy, câu trả lời sẽ sát với ý đồ của anh/chị hơn.
Tại sao câu trả lời của AI lại có lúc nhanh lúc chậm?
Khoảng thời gian anh/chị phải chờ từ lúc bấm gửi yêu cầu cho đến khi nhận được kết quả cuối cùng được gọi là độ trễ (latency). Rất nhiều người lầm tưởng tốc độ chậm là do công cụ bị lỗi, nhưng thực tế độ trễ được cấu thành từ ba phần riêng biệt.
Phần thứ nhất là thời gian truyền tải tín hiệu mạng lưới. Lệnh của anh/chị phải bay từ máy tính đến máy chủ của nhà cung cấp AI.
Phần thứ hai là thời gian hệ thống đọc hiểu câu lệnh. Hệ thống phải xử lý toàn bộ văn bản đầu vào trước khi nhả ra chữ cái đầu tiên. Đầu vào càng dài, phần thời gian này càng lớn.
Phần thứ ba là thời gian in ra kết quả. Mô hình phải chạy một vòng inference cho mỗi token (đơn vị từ/cụm ký tự) mà nó tạo ra. Vì thế, yêu cầu AI viết một bài dài hai nghìn chữ chắc chắn sẽ có độ trễ lớn hơn rất nhiều so với việc yêu cầu AI tóm tắt thành hai dòng ngắn gọn. Khi thiết kế câu lệnh, việc giới hạn trực tiếp độ dài đầu ra giúp AI tập trung vào đúng trọng tâm và tối ưu tốc độ phản hồi.
Trả giá bao nhiêu tiền cho thời gian chờ mô hình chạy?
Ví dụ, anh/chị đang chạy một chiến dịch quảng cáo CPAS (Facebook chạy về cửa hàng Shopee). Một shop có doanh số trên 100 triệu mỗi ngày, trong giai đoạn từ ngày 16-20/8/2026 đã ghi nhận 548 lượt mua hàng với tổng giá trị chuyển đổi đạt 32.222.984đ.
Trung bình mỗi đơn hàng này mang về doanh thu là: 32.222.984đ chia 548 bằng 58.801đ. Với chi phí để mua được một đơn hàng đang là 5.903đ, phần doanh thu còn lại của shop trên mỗi đơn sau khi trừ tiền quảng cáo là: 58.801đ trừ 5.903đ bằng 52.898đ.
Số liệu thực tế từ tài khoản đang vận hành, ghi nhận tại thời điểm nêu trên. Kết quả từng shop khác nhau tuỳ ngành hàng, giá bán và ngân sách.
Nếu anh/chị tự viết một công cụ AI để duyệt và kiểm tra thông tin của 548 đơn hàng này một cách tự động, tốc độ inference sẽ đóng vai trò quyết định. Giả sử hệ thống cần 4 giây cho mỗi lần inference một đơn hàng, tổng thời gian máy phải chạy là 548 nhân 4 bằng 2.192 giây (khoảng hơn 36 phút).
Trong 36 phút đó, dù tiến trình chạy ngầm không làm đơ máy tính của nhân viên, nhưng nếu quy trình yêu cầu phải có kết quả AI duyệt xong mới được chuyển giao cho khâu in đơn và đóng gói, thì 36 phút chờ đợi đó vẫn trở thành nút thắt cổ chai làm chậm trễ tiến độ vận hành của cả ca làm việc. Nếu một chiến dịch có đến năm nghìn đơn hàng, thời gian chờ sẽ lên đến sáu tiếng đồng hồ. Phần thời gian lãng phí ngồi chờ máy chạy này chính là chi phí ẩn ăn mòn trực tiếp vào phần doanh thu 52.898đ còn lại sau quảng cáo của từng đơn hàng. Việc đo lường thời gian phản hồi của AI không đơn thuần là vấn đề kỹ thuật, mà là bài toán hiệu suất vận hành của con người.
Kinh nghiệm thực chiến: Làm gì để AI xử lý số liệu bán hàng nhanh hơn?
Nhiều anh/chị mới tiếp cận AI thường mắc sai lầm là sao chép và dán toàn bộ dữ liệu thô vào cửa sổ chat. Lượng dữ liệu quá lớn sẽ khiến bộ nhớ của AI quá tải và thời gian inference bị kéo dài.
Lấy ví dụ với quảng cáo Shopee Ads loại Dịch vụ Hiển thị Sản phẩm. Một shop có doanh số trên 100 triệu mỗi ngày đã ghi nhận 73.200 lượt click và 6.500 đơn hàng chỉ trong đúng một ngày. Doanh số mang về là 516.147.215đ, chi phí bỏ ra là 78.286.766đ, tương đương mức ROAS đạt 6,59.
Số liệu thực tế từ tài khoản đang vận hành, ghi nhận tại thời điểm nêu trên. Kết quả từng shop khác nhau tuỳ ngành hàng, giá bán và ngân sách.
Anh/chị không bao giờ nên xuất danh sách chi tiết của 73.200 lượt click đó và ép AI phải đọc từng dòng. Việc tải lên một tệp tin chứa hơn bảy mươi nghìn dòng sẽ khiến quá trình inference sập hoàn toàn. Kinh nghiệm của tôi là hãy dùng các công cụ tính toán truyền thống như Excel để gom nhóm số liệu lại trước.
Sau đó, anh/chị chỉ cần đưa cho AI bộ chỉ số đã rút gọn: số tiền chi 78.286.766đ, số tiền thu 516.147.215đ và ROAS 6,59. Chỉ mất khoảng hai giây, quá trình inference đã hoàn thành xong nhiệm vụ đánh giá hiệu quả chiến dịch. Việc tách bạch giữa xử lý số lượng lớn bằng công cụ truyền thống và đọc hiểu ý nghĩa bằng AI là chìa khóa để giảm độ trễ về mức tối thiểu.
Các nền tảng quảng cáo đang dùng inference như thế nào?
Inference không chỉ nằm trong các công cụ viết lách. Hệ thống học máy của các mạng lưới quảng cáo lớn đang chạy inference hàng tỷ lần mỗi ngày để quyết định hiển thị video cho ai.
Khi theo dõi tài liệu hỗ trợ của TikTok dành cho nhà quảng cáo, anh/chị sẽ thấy nền tảng này sử dụng các chiến dịch hoàn toàn tự động hóa. Khi chạy TikTok Ads với loại chiến dịch GMV Max, hệ thống máy chủ của họ liên tục suy luận theo thời gian thực để tìm ra khách hàng tốt nhất. Chẳng hạn, một shop có doanh số trên 100 triệu mỗi ngày, vào ngày 08/8/2026 đã chủ động tăng ngân sách thêm 50,86% so với bảy ngày trước đó. Tổng chi phí trong ngày đạt 1.201,98 USD. Thay vì hiệu quả bị sụt giảm do đổ quá nhiều tiền, số lượng đơn hàng lại tăng tương ứng 51,69%, đạt mức 3.627 đơn. ROI của tài khoản giữ vững ổn định ở mức 6,92.
Số liệu thực tế từ tài khoản đang vận hành, ghi nhận tại thời điểm nêu trên. Kết quả từng shop khác nhau tuỳ ngành hàng, giá bán và ngân sách.
Để kết quả ROI không bị tụt khi ngân sách tăng gấp rưỡi, bộ máy của nền tảng phải chạy inference cực kỳ nhanh chóng. Theo hướng dẫn của Meta về cách nền tảng phân phối quảng cáo, hệ thống phải dự đoán giá trị mà quảng cáo mang lại trước khi người dùng kịp lướt đến. Máy chủ của nền tảng được trang bị phần cứng chuyên dụng để ép thời gian chờ xuống vài phần nghìn giây. Việc của chúng ta là cung cấp dữ liệu khách hàng chất lượng để hệ thống của nền tảng inference chính xác hơn, thay vì loay hoay tự xây dựng thuật toán phân tích riêng.
Xem cách hiểu AI để biến nhu cầu vận hành thành yêu cầu rõ ràng hơn
Câu hỏi thường gặp
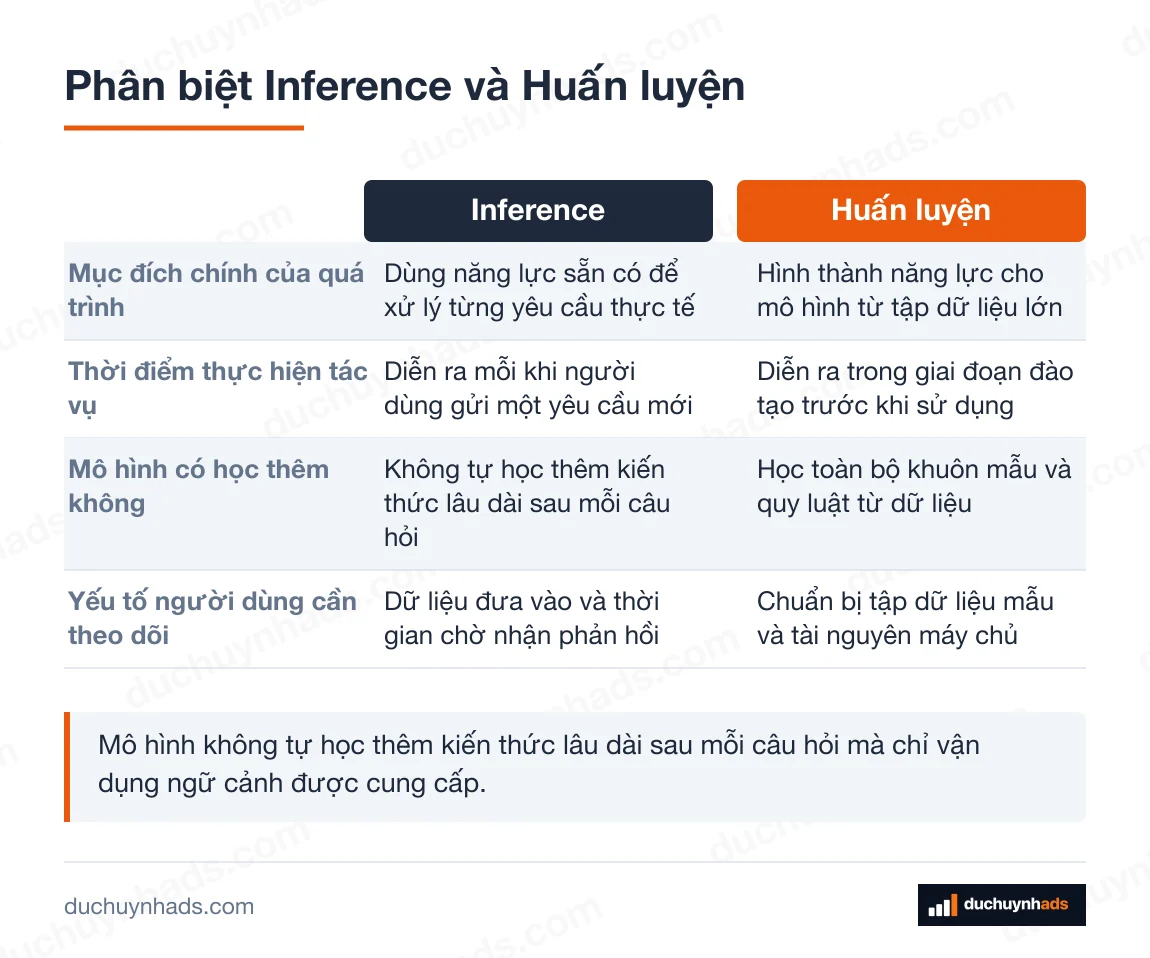
Inference khác gì với quá trình huấn luyện mô hình?
Huấn luyện là việc anh/chị cung cấp hàng tỷ đoạn văn bản vào hệ thống máy tính trong nhiều tháng liền để nó tự hình thành kiến thức. Quá trình này tốn hàng triệu đô la. Còn inference là việc máy tính sử dụng ngay lượng kiến thức đó để giải quyết một câu lệnh cụ thể của anh/chị. Mỗi lần inference chỉ mất vài giây và tiêu tốn một phần rất nhỏ của một cent (chưa tới vài chục đồng Việt Nam). Anh/chị là người dùng cuối thì chỉ trả tiền cho việc inference.
Tại sao AI lúc đầu trả lời rất nhanh, nhưng chat càng lâu thì tốc độ càng chậm?
Khi anh/chị chat liên tục trong cùng một khung cửa sổ, mô hình AI buộc phải đọc lại toàn bộ nội dung lịch sử từ câu đầu tiên. Càng chat nhiều, lượng chữ bắt buộc phải đọc lại càng khổng lồ. Việc ép máy tính xử lý lượng văn bản quá lớn này làm tiêu tốn rất nhiều tài nguyên, làm tăng độ trễ. Lời khuyên là hãy bấm nút tạo đoạn chat mới khi anh/chị cần chuyển sang chủ đề khác.
Bỏ bớt thông tin trong câu lệnh có giúp tốc độ phản hồi nhanh hơn không?
Chắc chắn là có. Việc cắt tỉa mọi văn bản thừa, những câu dẫn dắt rườm rà không liên quan trực tiếp đến kết quả sẽ giúp thời gian đọc hiểu ban đầu giảm xuống. Đầu vào càng ít chữ, quá trình inference càng bớt đi gánh nặng. Tuy nhiên, anh/chị không được bỏ đi những con số mang tính chất quyết định làm thay đổi kết luận cuối cùng.
Giới hạn độ dài câu trả lời có làm giảm thời gian chờ không?
Có. Thời gian in ra kết quả chiếm tỷ trọng lớn nhất trong tổng độ trễ. Quá trình inference diễn ra cho từng từ một, mô hình phải lặp lại vòng lặp suy luận cho đến khi in ra chữ cuối cùng. Việc yêu cầu AI chỉ trả lời ba gạch đầu dòng sẽ ngắt chu trình này sớm hơn, giúp kết quả hiện ra gần như ngay lập tức. Càng ít chữ được sinh ra, anh/chị càng phải đợi ít.
Có cách nào tính được trực tiếp chi phí chạy inference không?
Với giao diện web như ChatGPT, ai cũng có thể dùng bản Free miễn phí, chỉ các gói nâng cao mới thu tiền theo tháng (như Plus hay Pro). Anh/chị không cần tính tiền cho từng lượt chạy. Nhưng nếu anh/chị kết nối hệ thống trực tiếp qua API, các hãng sẽ tính phí dựa trên số lượng token xử lý. Họ công khai mức giá cho một triệu token đưa vào và một triệu token lấy ra. Anh/chị xem báo cáo tiêu thụ bao nhiêu token rồi nhân với đơn giá niêm yết là ra chi phí thật.