Mục lục · 7 phần
- AI không đọc chữ như người, AI tìm vị trí của ý nghĩa
- Một câu hỏi đi qua hệ thống embedding như thế nào?
- Điểm tương đồng cao có nghĩa là gì, và không có nghĩa là gì?
- Tìm kiếm từ khóa và tìm kiếm theo nghĩa nên đi cùng nhau
- Một tình huống cụ thể để tránh trả lời nghe đúng mà sai việc
- Khi nào shop hoặc đội marketing nên dùng vector embedding?
- Câu hỏi thường gặp
Trả lời nhanh
Vector embedding là cách đổi chữ, hình ảnh hoặc sản phẩm thành dãy số để máy so sánh mức độ gần nghĩa. Hệ thống nhờ đó tìm được tài liệu liên quan dù câu hỏi của anh/chị dùng từ khác với tài liệu. Với kho hướng dẫn trả lời khách và mô tả sản phẩm, anh/chị nên kết hợp tìm theo nghĩa với từ khóa.
Vector embedding là cách AI đổi một đoạn chữ, hình ảnh hoặc sản phẩm thành một dãy số để máy nhận ra chúng có gần nghĩa hay không. Nhờ dãy số này, hệ thống có thể tìm nội dung liên quan dù người tìm dùng câu chữ khác hẳn câu chữ trong tài liệu.
AI không đọc chữ như người, AI tìm vị trí của ý nghĩa
Anh/chị có thể hình dung một kho tài liệu của shop: hướng dẫn trả lời khách, mô tả sản phẩm, quy định đổi trả, kịch bản quảng cáo và bài viết cũ. Người làm lâu ngày nhớ đại khái mỗi thứ nằm ở đâu. Máy thì không có kiểu nhớ đó. Máy cần một cách để biến nội dung thành thứ có thể so sánh được, và vector embedding chính là công cụ làm phần việc này. “Vector” là một dãy số. “Embedding” là việc đặt ý nghĩa của dữ liệu vào dãy số đó. Từng số trong dãy không phải nhãn dễ đọc như “màu đỏ”, “áo” hay “khách đang hỏi giá”. Giá trị của cả dãy nằm ở vị trí của nó so với những dãy khác.
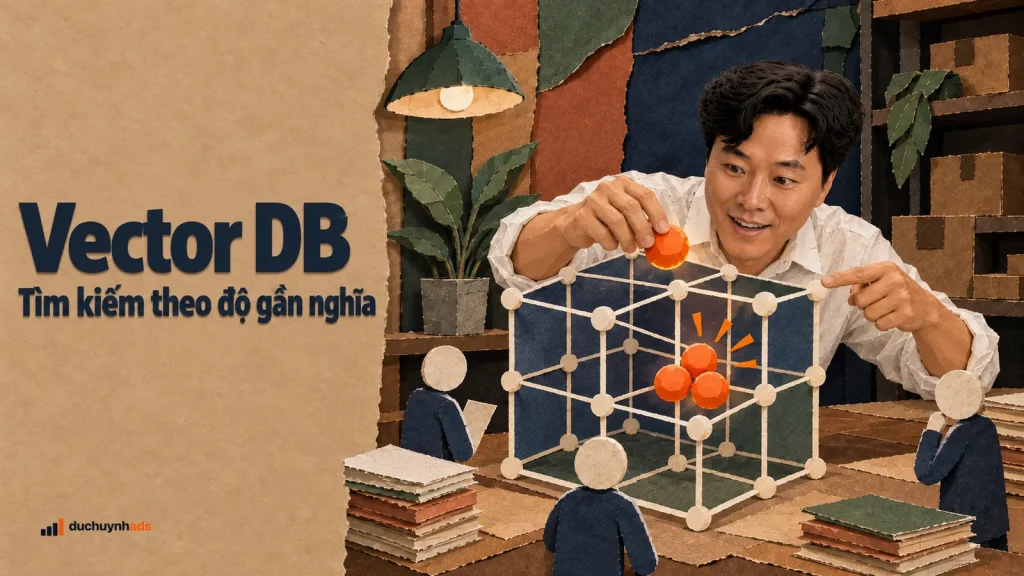
Hãy nghĩ đến một tấm bản đồ. Trên bản đồ địa lý, hai địa điểm gần nhau vì khoảng cách. Trên bản đồ embedding, hai nội dung nằm gần nhau vì chúng nói về những việc gần nghĩa. Câu “khách muốn đổi size” có thể ở gần tài liệu “quy trình hỗ trợ đổi kích cỡ”. Hai câu không giống từ, nhưng cùng hướng về một nhu cầu.
Điều này khác với việc dò đúng chữ. Nếu khách gõ “đổi cỡ thế nào”, công cụ chỉ tìm từ khóa có thể bỏ qua tài liệu dùng chữ “kích thước”. Công cụ dùng embedding có cơ hội đưa tài liệu đó vào danh sách vì đã học được mối liên hệ về nghĩa. “Có cơ hội” là điểm cần nhớ: embedding giúp chọn tài liệu phù hợp hơn, chứ không tự xác nhận tài liệu đó còn hiệu lực hay câu trả lời của nó là đúng.
Khi một hệ thống hỏi đáp dùng LLM, embedding thường đứng ở bước tìm tài liệu trước. Hệ thống biến câu hỏi của người dùng thành vector, tìm các đoạn có vector gần nó, rồi đưa các đoạn đó cho mô hình ngôn ngữ đọc. Nếu bước tìm sai tài liệu, mô hình phía sau có thể trả lời rất trôi chảy nhưng lệch vấn đề của khách.
Một câu hỏi đi qua hệ thống embedding như thế nào?
Quy trình thường bắt đầu từ dữ liệu đã có. Người quản trị không đưa cả một cuốn tài liệu dài vào tìm kiếm như một khối duy nhất. Họ tách nó thành các đoạn có thể đứng riêng: một đoạn nói về điều kiện đổi trả, một đoạn nói về thời gian xử lý, một đoạn nói về sản phẩm không áp dụng. Việc chia này thường được gọi là chia đoạn, tức cắt tài liệu thành phần nhỏ nhưng vẫn đủ ngữ cảnh để hiểu.
Sau đó, mô hình tạo một vector cho từng đoạn và lưu vector cùng nội dung gốc. Anh/chị cần lưu cả hai. Vector giúp tìm nhanh, còn đoạn văn gốc là thứ con người và mô hình ngôn ngữ thực sự đọc để trả lời.
Khi có câu hỏi mới, hệ thống cũng tạo vector cho câu hỏi ấy. Nó so vector câu hỏi với các vector đã lưu rồi xếp những đoạn gần nhất lên trước. Đây là tìm kiếm ngữ nghĩa, nghĩa là tìm theo ý chứ không chỉ dò chuỗi ký tự trùng nhau.
Ví dụ, khách nhắn “mua rồi mà mặc chật có gửi lại được không?”. Hệ thống có thể tìm đến đoạn về đổi kích cỡ, thay vì chỉ tìm tài liệu có đúng chữ “gửi lại”. Nhưng trước khi trả lời, hệ thống vẫn nên kiểm tra điều kiện đi kèm như sản phẩm còn nguyên hay không, thời hạn áp dụng là gì và chính sách có được cập nhật chưa. Những điều kiện đó không tự xuất hiện chỉ vì hai đoạn gần nghĩa.
Đây là lý do metadata rất quan trọng. Metadata là thông tin gắn kèm để mô tả một đoạn dữ liệu, chẳng hạn loại tài liệu, trạng thái còn dùng được, kênh áp dụng hoặc quyền được xem. Một câu hướng dẫn nội bộ đã cũ có thể rất gần về nghĩa với câu hỏi hiện tại. Bộ lọc metadata giúp hệ thống không lấy nhầm bản cũ chỉ vì nó viết cùng chủ đề.
Điểm tương đồng cao có nghĩa là gì, và không có nghĩa là gì?
Sau khi so sánh, nhiều hệ thống trả về một điểm tương đồng. Điểm này mô tả mức độ các vector nằm gần nhau theo cách mô hình đang biểu diễn dữ liệu. Nó không phải phần trăm chắc chắn câu trả lời đúng. Nó cũng không phải lời khẳng định hai đoạn có thể thay thế cho nhau.
Người mới hay mắc một lỗi rất dễ hiểu: thấy kết quả đầu tiên có điểm cao là dừng kiểm tra. Cách làm an toàn hơn là đọc đoạn gốc và tự hỏi ba điều. Đoạn đó có trả lời đúng ý định của người hỏi không? Nó có đủ điều kiện, ngoại lệ và ngữ cảnh không? Nó còn là bản đang áp dụng không?
Điểm tương đồng chỉ có ích khi anh/chị so chúng trong cùng một hệ thống. Không nên mang một điểm của mô hình này sang so với điểm của mô hình khác, rồi kết luận mô hình nào hiểu tiếng Việt hơn. Mỗi mô hình có cách tạo vector khác nhau. Cách chia đoạn, độ dài đoạn và cách chuẩn bị dữ liệu cũng làm thứ tự kết quả thay đổi.
Vector embedding không đo lường doanh thu, chi phí hay lợi nhuận. Điểm tương đồng chỉ cho biết tài liệu nào gần nghĩa với câu hỏi, không phản ánh chiến dịch đang lời hay lỗ. Khi dùng embedding cho shop, thứ cần kiểm tra là câu hỏi có tìm đúng hướng dẫn không; còn hiệu quả kinh doanh phải được đo bằng báo cáo bán hàng và quảng cáo riêng.
Một cách thử thực tế là lập một danh sách các câu khách thật sự hay hỏi. Trong danh sách cần có câu viết không dấu, câu sai chính tả, câu ngắn, câu dùng tiếng lóng và câu có nhiều ý. Mỗi lần hệ thống trả kết quả, người phụ trách chấm xem tài liệu đầu tiên có dùng được không. Bài kiểm tra này cho thấy vấn đề nằm ở dữ liệu, ở cách chia đoạn hay ở chính mô hình, thay vì chỉ nhìn một điểm tương đồng đẹp trên màn hình.
Tìm kiếm từ khóa và tìm kiếm theo nghĩa nên đi cùng nhau
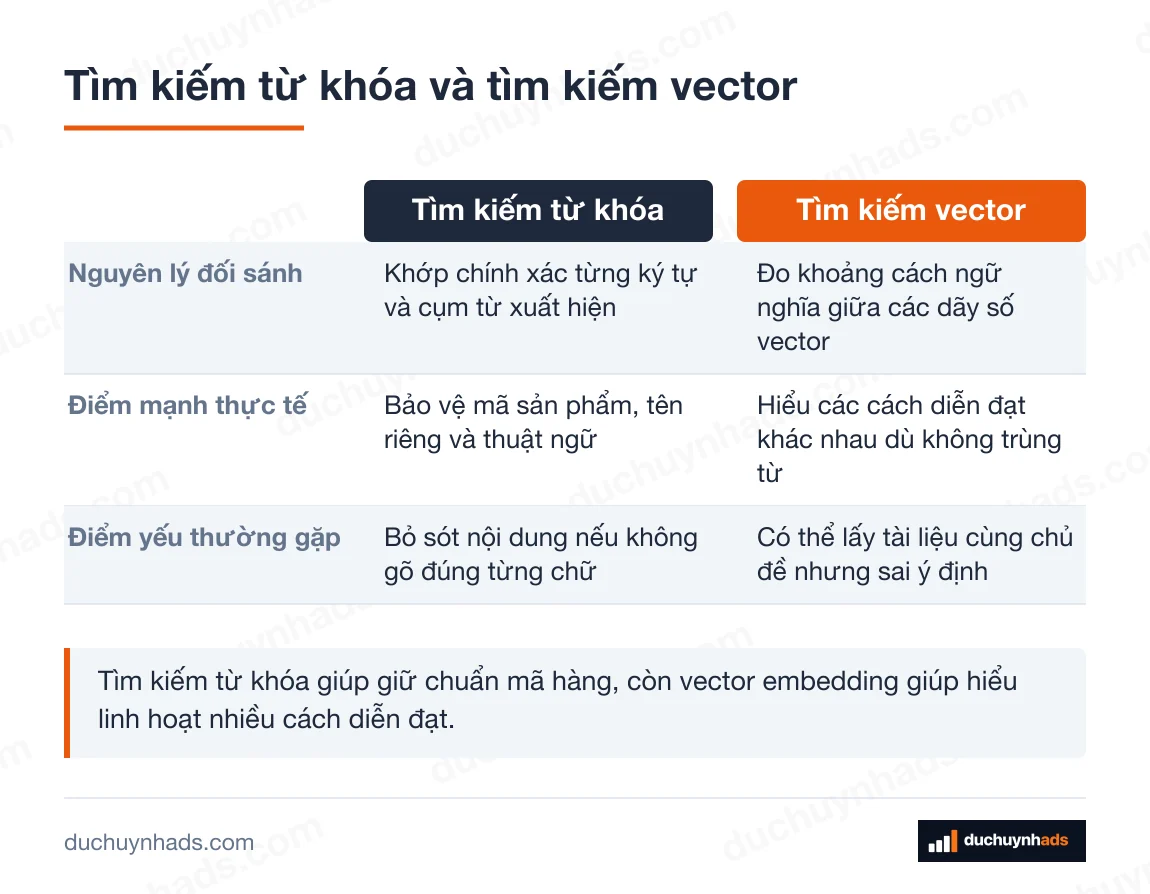
Tìm kiếm từ khóa tìm các chữ xuất hiện đúng hoặc gần đúng trong tài liệu. Nó rất hữu ích khi câu hỏi có mã sản phẩm, tên chương trình, mã lỗi, tên riêng hoặc một điều kiện bắt buộc. Những chi tiết này không nên bị “hiểu gần đúng”.
Tìm kiếm vector lại mạnh khi người dùng diễn đạt một ý theo nhiều cách. Khách có thể nói “hàng về chưa”, “bao giờ có lại” hoặc “còn size này không”. Nếu dữ liệu có hướng dẫn về tình trạng hàng, embedding có thể nối các cách nói đó với nhau tốt hơn việc chỉ chờ một từ khóa cố định.
Trong thực tế, hệ thống tốt thường dùng cả hai. Từ khóa giữ các chi tiết phải chính xác. Embedding mở rộng phạm vi các cách diễn đạt. Sau đó bộ lọc metadata loại nội dung sai kênh, hết hiệu lực hoặc người dùng không có quyền xem. Cuối cùng, mô hình ngôn ngữ mới dùng tài liệu đã chọn để soạn câu trả lời.
Vì thế, đừng xem embedding là một chiếc hộp thần kỳ thay cho việc sắp xếp kho nội dung. Nếu tài liệu thiếu, trùng lặp hoặc lẫn bản cũ với bản mới, hệ thống chỉ tìm nhanh hơn trong một kho đang lộn xộn. Việc đặt tên tài liệu rõ ràng, ghi ngày cập nhật và tách từng chủ đề có ranh giới vẫn là nền móng.
Một tình huống cụ thể để tránh trả lời nghe đúng mà sai việc
Hãy hình dung anh/chị xây trợ lý nội bộ cho đội chăm sóc khách hàng. Trong kho có một bài hướng dẫn xử lý đổi trả và một bài hướng dẫn trả lời khi khách chỉ hỏi thêm thông tin sản phẩm. Cả hai đều có thể nhắc đến từ “đơn hàng”, “khách” và “gửi lại”. Nếu tài liệu được cắt quá ngắn, hệ thống có thể lấy một câu chung chung rồi bỏ mất phần điều kiện quan trọng nằm ở đoạn kế tiếp.
Cách xử lý không phải là bắt mô hình “thông minh hơn” bằng một câu lệnh dài. Trước hết, hãy xem lại đoạn mà hệ thống đã lấy. Đoạn có còn chủ ngữ và điều kiện không? Tiêu đề chính sách có đi cùng nội dung không? Phần ngoại lệ có bị tách khỏi quy tắc chung không? Sau đó mới thử lại bằng những câu hỏi giống cách khách nhắn thật.
Nếu hệ thống tìm được tài liệu đúng nhưng câu trả lời vẫn có vấn đề, lỗi có thể nằm ở bước tạo câu trả lời. Nếu hệ thống không tìm thấy tài liệu phù hợp, lỗi có thể nằm ở dữ liệu, cách chia đoạn hoặc embedding. Tách hai loại lỗi này giúp đội ngũ sửa đúng chỗ. Gộp chúng thành nhận xét “AI trả lời dở” thì không biết phải cải thiện từ đâu.
Tình huống này cũng áp dụng khi xây sản phẩm Generative AI. Nội dung tạo ra chỉ đáng tin đến mức nguồn mà hệ thống được phép lấy. Embedding là công cụ chọn nguồn theo nghĩa; nó không thay người quản trị quyết định nguồn nào được phép dùng cho khách hàng.
Khi nào shop hoặc đội marketing nên dùng vector embedding?
Embedding phù hợp khi anh/chị có nhiều nội dung chữ và người dùng thường hỏi cùng một việc bằng nhiều cách. Đó có thể là kho câu trả lời chăm sóc khách, tài liệu đào tạo nhân viên, mô tả sản phẩm, kiến thức về ngành hàng hoặc thư viện nội dung marketing.
Nó ít cần thiết hơn khi dữ liệu rất nhỏ và câu hỏi luôn theo mẫu cố định. Nếu đội chỉ có vài câu trả lời ngắn, một danh mục rõ ràng hoặc tìm kiếm từ khóa đơn giản có thể đủ và dễ kiểm soát hơn. Đừng triển khai thêm công nghệ chỉ vì nghe tên mới; hãy bắt đầu từ câu hỏi nào đang tốn thời gian tìm nhất và dữ liệu nào đang khó tra nhất.
Trước khi đưa vào dùng thật, anh/chị nên chuẩn bị nội dung sạch. Loại bớt bản trùng, đánh dấu bản hết hiệu lực, ghi rõ đối tượng áp dụng và không đưa dữ liệu nhạy cảm vào kho nếu người tìm không được phép xem. Sau đó thử với các câu hỏi thật của đội. Việc này thường cho kết quả rõ hơn là chỉ so thông số kỹ thuật giữa các mô hình.
Nếu anh/chị muốn ghép AI vào công việc marketing thay vì chỉ làm chatbot, hãy xem thêm cách ghép nền tảng AI với các tình huống marketing cụ thể. Tài liệu kỹ thuật của OpenAI về embeddings cũng là điểm bắt đầu hữu ích khi cần xem cách một dịch vụ AI mô tả việc tạo và sử dụng vector: OpenAI Embeddings guide.
Câu hỏi thường gặp
Vector embedding có phải là AI không?
Vector embedding là một kỹ thuật được dùng trong hệ thống AI. Bản thân vector chỉ là dãy số; ý nghĩa của nó đến từ mô hình đã tạo vector và dữ liệu dùng để huấn luyện hoặc biểu diễn. Anh/chị nên xem nó là một bộ phận giúp AI tìm và so sánh nội dung, không phải một trợ lý có thể tự ra quyết định.
Vector embedding dùng được cho dữ liệu tiếng Việt không?
Có, nếu anh/chị chọn mô hình hỗ trợ tiếng Việt hoặc mô hình đa ngôn ngữ phù hợp. Tuy nhiên, không nên chỉ tin vào mô tả của nhà cung cấp. Hãy thử với cách khách và nhân viên của anh/chị thật sự viết, gồm cả tiếng Việt không dấu, tên sản phẩm và cách nói địa phương.
Tìm kiếm vector có thay thế tìm kiếm từ khóa không?
Không nên thay thế hoàn toàn. Tìm kiếm vector giỏi hiểu các cách diễn đạt gần nghĩa, còn tìm kiếm từ khóa giữ được mã sản phẩm, tên riêng và điều kiện cần khớp chính xác. Dùng hai cách cùng nhau thường dễ kiểm soát hơn là bắt một cách làm hết mọi việc.
Có cần biết lập trình mới dùng vector embedding không?
Không nhất thiết, vì có công cụ và dịch vụ đã đóng gói sẵn. Nhưng anh/chị vẫn cần hiểu dữ liệu nào được đưa vào, ai được tìm và tài liệu nào còn hiệu lực. Không có phần mềm nào tự sửa được một kho kiến thức lẫn lộn hoặc một chính sách chưa được cập nhật.
Vì sao chatbot tìm đúng tài liệu mà vẫn trả lời sai?
Vì tìm tài liệu và viết câu trả lời là hai bước khác nhau. Embedding có thể đã chọn đúng đoạn, nhưng mô hình tạo sinh có thể bỏ sót điều kiện hoặc diễn đạt quá mức so với nguồn. Khi kiểm tra, hãy xem cả đoạn gốc mà hệ thống lấy lẫn câu trả lời cuối cùng.
Có nên đưa toàn bộ file tài liệu vào một vector không?
Thường không nên. Một file quá dài chứa nhiều chủ đề khiến vector trở nên chung chung, còn cắt quá vụn lại làm mất điều kiện cần thiết. Hãy tách theo từng ý có thể tự hiểu, đồng thời giữ tiêu đề và thông tin bối cảnh đi cùng đoạn.
Vector embedding có tự học từ mọi câu khách nhắn không?
Không mặc định như vậy. Nhiều hệ thống chỉ tạo vector để tìm dữ liệu đã được duyệt, không tự dùng từng cuộc trò chuyện để huấn luyện lại mô hình. Anh/chị cần xem rõ công cụ mình dùng lưu gì, cho phép ai truy cập và quy trình nào đưa nội dung mới vào kho.