Mục lục · 7 phần
Trả lời nhanh
Training data là những mẫu thông tin AI dùng để học cách nhận ra, phân loại hoặc tạo câu trả lời. AI cần mẫu đúng để học giọng bán hàng và cách xử lý bình luận của shop anh/chị. Anh/chị nên chuẩn bị dữ liệu đúng việc, sạch và có bối cảnh, chẳng hạn các đoạn hội thoại đã được xử lý đúng.
Training data là dữ liệu huấn luyện: những mẫu thông tin AI đã xem để học cách nhận ra, phân loại hoặc tạo ra câu trả lời. AI không tự biết giọng bán hàng của shop hay đâu là một bình luận cần xử lý; nó cần mẫu đúng để học theo.
Training data giống tài liệu bàn giao cho người mới
Hãy hình dung anh/chị bàn giao việc cho một nhân viên mới. Nếu chỉ nói “hãy trả lời khách cho tốt”, người đó sẽ phải đoán: lúc nào báo giá, lúc nào xin thêm thông tin, lúc nào chuyển cho bộ phận khác. Nếu có sẵn các đoạn hội thoại đã được xử lý đúng, nhân viên có điểm tham chiếu rõ hơn. Training data cũng đóng vai trò tương tự đối với AI. Nó là phần thông tin được đưa vào để AI học mẫu. Mẫu có thể là đoạn văn, ảnh có nhãn, bản ghi âm, câu hỏi và câu trả lời, hoặc bảng bán hàng. “Có nhãn” nghĩa là người chuẩn bị đã chỉ cho máy biết nội dung đó thuộc loại nào. Chẳng hạn, một tin nhắn được ghi là “hỏi giá”, còn tin nhắn khác được ghi là “khiếu nại”.
AI không ghi nhớ dữ liệu như một cuốn sổ để lật lại từng trang. Nó tìm các điểm thường đi cùng nhau trong rất nhiều mẫu. Vì vậy, training data không phải là một câu lệnh anh/chị gõ vào hôm nay. Câu lệnh đó là yêu cầu hiện tại. Training data là nền học đã có trước khi AI trả lời, hoặc là bộ mẫu được dùng để xây dựng một công cụ riêng.
Muốn hiểu vì sao máy có thể rút ra mẫu từ dữ liệu, anh/chị có thể đọc thêm những nền tảng cơ bản về cách trí tuệ nhân tạo tư duy. Điều cần nhớ trước tiên là: AI học từ những gì được đưa cho nó, nên dữ liệu đầu vào sẽ ảnh hưởng trực tiếp đến kiểu kết quả mà nó tạo ra.
Đừng nhầm dữ liệu huấn luyện với file anh/chị vừa tải lên
Khi tải một bảng doanh thu lên công cụ AI và hỏi “mặt hàng nào bán chậm”, anh/chị đang cung cấp dữ liệu để công cụ phân tích trong cuộc trao đổi đó. Việc này hữu ích, nhưng chưa chắc là huấn luyện lại mô hình. Nhiều công cụ chỉ đọc file để trả lời yêu cầu hiện tại, rồi không biến file ấy thành kiến thức mới cho tất cả lần dùng sau.
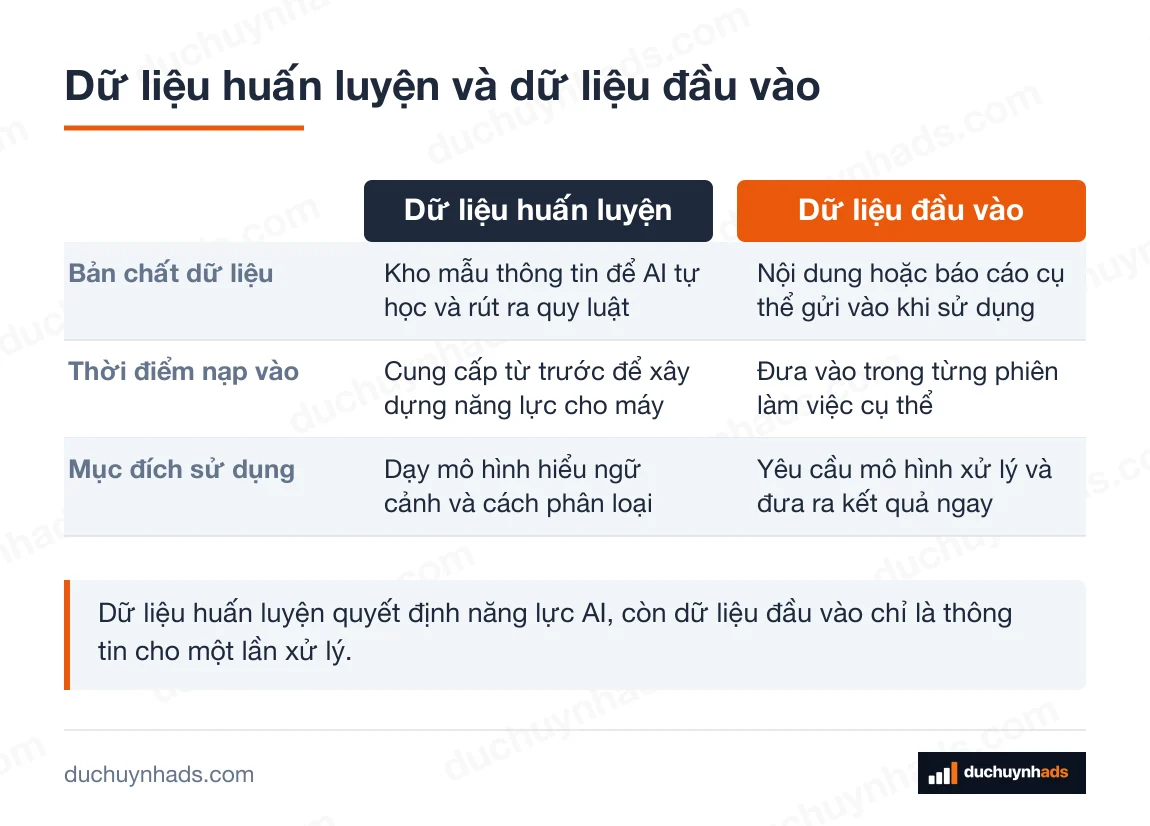
Training data thường xuất hiện sớm hơn. Nhà phát triển dùng nó để xây dựng hoặc tinh chỉnh hệ thống. “Tinh chỉnh” nghĩa là cho một mô hình đã biết ngôn ngữ học thêm cách làm một việc hẹp hơn, như nhận diện loại yêu cầu chăm sóc khách hàng theo quy tắc của doanh nghiệp.
Sự khác nhau này giúp anh/chị đặt kỳ vọng đúng. Một chatbot được đưa tài liệu sản phẩm trong lúc trò chuyện có thể trả lời dựa vào tài liệu đó. Nhưng nếu tài liệu thiếu chính sách đổi trả, chatbot không tự biết phần bị thiếu. Nếu anh/chị muốn nó trả lời nhất quán nhiều lần, cần chuẩn bị nguồn thông tin rõ ràng, cập nhật và có cách kiểm tra.
Với báo cáo quảng cáo cũng vậy. AI có thể đọc các cột chi phí, lượt nhấp và đơn hàng trong file anh/chị gửi. Nó không vì thế mà hiểu mọi cách đặt tên nội bộ của shop. Trước khi hỏi, hãy nói rõ từng cột là gì, dữ liệu lấy từ đâu và khoảng thời gian nào. Nếu dùng dữ liệu từ báo cáo web, hãy đối chiếu cách nền tảng ghi nhận chỉ số trong tài liệu Google Analytics trước khi biến kết luận của AI thành quyết định kinh doanh.
Một bộ dữ liệu tốt cần đúng việc, sạch và có bối cảnh
Nhiều người nghĩ cứ gom thật nhiều file là AI sẽ tốt hơn. Không hẳn. Một kho dữ liệu lẫn câu trả lời cũ, thông tin sản phẩm đã ngừng bán và ghi chú viết tắt khó hiểu có thể làm công cụ trả lời lộn xộn hơn. AI nhìn thấy mẫu lặp lại; nếu mẫu lặp lại đang sai, nó có thể học cách sai đó.
Đúng việc nghĩa là dữ liệu phải gần với công việc anh/chị muốn AI làm. Nếu muốn phân loại tin nhắn, các đoạn hội thoại thực tế đã được che thông tin riêng tư sẽ hữu ích hơn một loạt bài quảng cáo. Nếu muốn viết mô tả sản phẩm theo phong cách của shop, các mô tả đã được duyệt sẽ phù hợp hơn những đoạn văn không liên quan.
Sạch nghĩa là bỏ nội dung trùng, sửa lỗi rõ ràng và không trộn các phiên bản mâu thuẫn mà không ghi chú. Ví dụ, cùng một sản phẩm nhưng một file ghi còn hàng, file khác ghi ngừng bán. Nếu chưa chọn được thông tin nào đúng, đừng đưa cả hai vào cùng một nguồn rồi chờ AI tự đoán. Hãy xác định bản đang dùng hoặc đánh dấu rõ ngày cập nhật.
Có bối cảnh nghĩa là người đọc dữ liệu, dù là người hay AI, biết nó dùng trong tình huống nào. Một câu “có hàng không?” không đủ để phân loại nếu không biết khách đang hỏi sản phẩm nào. Một con số doanh thu cũng không tự nói được lý do tăng hoặc giảm. Gắn nguồn, thời gian, tên trường dữ liệu và ghi chú cần thiết giúp câu trả lời ít suy diễn hơn.
Ví dụ gần với việc bán hàng hằng ngày
Anh/chị muốn làm một trợ lý để chuyển tin nhắn khách tới đúng người phụ trách. Nguồn chuẩn bị có thể gồm các hội thoại đã được chọn lọc. Mỗi hội thoại đi kèm một nhãn dễ hiểu như hỏi sản phẩm, hỏi tình trạng giao hàng, cần đổi trả hoặc cần tư vấn thêm. Nhãn là câu trả lời cho câu hỏi: “đoạn này thuộc việc gì?”
Nếu có đoạn khách nhắn “mẫu này còn màu tối không?” và nó được gắn nhãn hỏi sản phẩm, AI có cơ sở để nhận ra những cách hỏi tương tự. Nếu một đoạn “đơn của tôi đang ở đâu?” được gắn nhãn giao hàng, hệ thống có thể gợi ý chuyển cuộc trò chuyện đó cho đúng luồng. Mục tiêu không phải để AI thay nhân viên quyết định mọi trường hợp, mà để giảm việc đọc lại các tin nhắn giống nhau.
Một tình huống khác là soạn nội dung. Anh/chị có thể tập hợp các bài đã được duyệt, kèm ghi chú về sản phẩm, nhóm khách và điều không được nói. Những ghi chú này quan trọng vì một bài bán được chưa chắc phù hợp với mọi sản phẩm. AI cần biết ranh giới của công việc, không chỉ nhìn thấy giọng văn.
Trong dự báo bán hàng, dữ liệu có thể là lịch sử đơn theo ngày, thông tin hàng đã hủy và thời điểm hết hàng. Đừng đưa một file thiếu các cột quan trọng rồi yêu cầu AI kết luận chắc chắn về lượng cần nhập. Đây là phần gần với machine learning, tức cách máy học từ mẫu để dự đoán hoặc phân loại. Dự đoán chỉ là gợi ý dựa trên dữ liệu đã có, không phải lời hứa về số bán trong tương lai.
Chỗ người mới hay làm AI trả lời sai
Lỗi phổ biến là dùng dữ liệu thật nhưng không kiểm tra câu trả lời mẫu. Trong phần chăm sóc khách, có những câu trả lời cũ có thể được viết khi chính sách còn khác. Nếu lấy nguyên cả kho chat để làm nguồn, AI có thể lặp lại câu trả lời đã lỗi thời với giọng rất tự tin.
Lỗi tiếp theo là để dữ liệu chứa thông tin nhạy cảm không cần thiết. Danh sách khách thường có số điện thoại, địa chỉ, mã đơn hoặc ghi chú cá nhân. Nếu mục tiêu chỉ là phân loại ý định mua, các chi tiết nhận diện này không giúp AI hiểu ý định tốt hơn. Hãy bỏ hoặc che chúng trước khi đưa sang công cụ bên ngoài.
Một lỗi khác là không tách dữ liệu tham khảo khỏi chỉ dẫn. Anh/chị có thể có tài liệu sản phẩm tốt, nhưng vẫn cần nói rõ AI phải làm gì với tài liệu đó: trả lời ngắn, không đoán khi thiếu thông tin, hay chuyển sang người thật khi gặp khiếu nại. Dữ liệu cho AI biết “biết gì”; chỉ dẫn cho AI biết “làm gì”.
Cuối cùng, đừng xem câu trả lời trôi chảy là bằng chứng nó đúng. Với nội dung liên quan giá, tồn kho, chính sách hay khách hàng, hãy kiểm tra lại bằng nguồn gốc. Khi bài toán là đọc ý nghĩa của tin nhắn và văn bản, khái niệm NLP sẽ giúp anh/chị hiểu thêm cách máy xử lý ngôn ngữ tự nhiên.
Chuẩn bị dữ liệu trước khi giao cho AI
Hãy bắt đầu từ một công việc nhỏ, lặp lại và dễ kiểm tra. Chọn một mục tiêu rõ ràng, chẳng hạn phân loại loại tin nhắn hoặc soạn bản nháp mô tả. Sau đó chọn những mẫu gần nhất với mục tiêu ấy, bỏ nội dung không liên quan và thống nhất cách đặt tên nhãn.
Đọc lại dữ liệu như thể anh/chị là người mới nhận việc. Có từ viết tắt nào chỉ đội nội bộ mới hiểu không? Có quy định nào đã thay đổi nhưng vẫn nằm trong file không? Có câu trả lời nào chỉ đúng cho một sản phẩm mà lại dễ bị hiểu là đúng cho tất cả không? Những điểm này nên được sửa trước, không phải đợi AI trả lời sai mới sửa.
Sau khi thử, hãy lưu lại những câu AI trả lời đúng và những trường hợp cần người thật xử lý. Phần phản hồi đó giúp anh/chị cải thiện nguồn mẫu hoặc chỉ dẫn ở lần sau. Cách làm này thực tế hơn việc cố xây một hệ thống biết mọi thứ ngay từ đầu.
Câu hỏi thường gặp
Training data có phải là file Excel tôi tải lên ChatGPT không?
Không phải lúc nào cũng vậy. File anh/chị tải lên thường là dữ liệu để AI đọc và hỗ trợ trong yêu cầu hiện tại. Training data là dữ liệu được dùng để xây dựng hoặc dạy một hệ thống nhận ra mẫu từ trước; mỗi công cụ có cách xử lý file tải lên khác nhau.
Tôi có cần biết code mới tự chuẩn bị training data không?
Không. Anh/chị vẫn có thể bắt đầu bằng bảng tính, tài liệu câu hỏi thường gặp hoặc các hội thoại đã được sắp xếp. Code chỉ cần khi muốn tự động hóa việc thu thập, làm sạch hoặc đưa dữ liệu vào một hệ thống riêng.
Muốn AI phân loại bình luận khách thì phải đưa cho nó những gì?
Hãy đưa các bình luận gần với tình huống thật, cùng nhãn phân loại rõ ràng và hướng dẫn cách xử lý từng nhãn. Loại bỏ thông tin riêng tư không phục vụ việc phân loại. Anh/chị cũng nên giữ lại các bình luận khó để kiểm tra xem AI có đang hiểu nhầm hay không.
Dữ liệu cũ có làm chatbot trả lời sai không?
Có thể. Nếu dữ liệu cũ chứa giá, tồn kho hoặc chính sách không còn áp dụng, chatbot có thể nhắc lại thông tin đó. Hãy ghi rõ phiên bản đang dùng và thay hoặc loại bỏ nội dung đã hết hiệu lực trước khi dùng làm nguồn.
Dùng dữ liệu khách hàng để huấn luyện AI có an toàn không?
Không nên đưa nguyên bản dữ liệu khách hàng nếu không thực sự cần. Trước hết hãy bỏ các thông tin nhận diện như số điện thoại, địa chỉ và mã đơn. Sau đó đọc điều khoản bảo mật của công cụ anh/chị định dùng và chỉ chia sẻ phần dữ liệu phù hợp với mục tiêu.
Vì sao AI đọc tài liệu của shop mà vẫn bịa câu trả lời?
AI có thể suy đoán để lấp chỗ thiếu khi tài liệu không nêu rõ câu trả lời. Hãy yêu cầu nó nói không biết hoặc chuyển cho người phụ trách khi không tìm thấy thông tin trong nguồn. Đồng thời kiểm tra xem tài liệu có mâu thuẫn, thiếu bối cảnh hoặc dùng từ nội bộ khó hiểu hay không.
Tôi muốn AI viết đúng giọng của shop thì nên chuẩn bị gì?
Hãy chọn các bài đã được duyệt và còn phù hợp với cách bán hàng hiện tại. Kèm theo đó là ghi chú về khách hàng mục tiêu, các thông tin bắt buộc phải có và những điều không được hứa. Đừng chỉ đưa bài viết hay rồi mong AI tự hiểu giới hạn của thương hiệu.