Mục lục · 5 phần
Trả lời nhanh
Vector database là hệ thống lưu trữ dữ liệu dạng dãy số để tìm thông tin theo sự tương đồng về ý nghĩa. Kỹ thuật Vector Embeddings chuyển câu văn thành các tọa độ số, còn cơ sở dữ liệu vector lưu những tọa độ đó. Nhờ vậy, anh/chị có thể tìm tài liệu theo nghĩa thay vì chỉ khớp từng chữ.
Vector Database là hệ thống lưu trữ văn bản, hình ảnh dưới dạng các dãy số toán học. Công nghệ này cho phép máy tính tìm kiếm thông tin dựa trên sự tương đồng về mặt ý nghĩa, thay vì chỉ khớp đúng từng chữ cái. Đây là lớp nền tảng để xây dựng các công cụ tìm kiếm thông minh.
Vector Database biến chữ viết thành dãy số như thế nào?
Để máy tính hiểu được ngôn ngữ con người, hệ thống bắt buộc phải dùng một kỹ thuật chuyển đổi gọi là Vector Embeddings. Kỹ thuật này dịch một câu văn thành một danh sách dài bao gồm hàng nghìn các con số. Danh sách này chính là tọa độ định vị của câu văn đó trong một không gian toán học nhiều chiều. Cơ sở dữ liệu vector là nơi chuyên dùng để lưu trữ toàn bộ các tọa độ phức tạp này.
Khi anh/chị gõ một câu hỏi vào ô tìm kiếm, hệ thống trí tuệ nhân tạo cũng lập tức dịch câu hỏi đó thành một tọa độ mới. Sau đó, nó đưa tọa độ này vào cơ sở dữ liệu để đối chiếu. Nhiệm vụ của Vector Database lúc này là đo lường khoảng cách từ điểm truy vấn đến hàng triệu điểm dữ liệu đang có sẵn trong kho. Điểm tọa độ nào nằm càng gần nhau thì nội dung của chúng càng sát với ý nghĩa câu hỏi ban đầu.
Ví dụ, cụm từ “chó cảnh” và “mèo cưng” sẽ được máy tính xếp rất gần nhau vì chúng đều chung nhóm động vật nuôi trong nhà. Cụm từ “xe hơi thể thao” sẽ bị đẩy ra một khu vực hoàn toàn khác. Nhờ cách sắp xếp tọa độ thông minh này, máy tính có thể hiểu được bối cảnh nội dung mà không cần con người giải thích. Cơ sở dữ liệu vector xử lý việc quét và tìm kiếm các điểm lân cận này cực kỳ nhanh chóng. Quá trình tính toán thường chỉ diễn ra trong vòng vài phần nghìn giây. Sau khi tính xong, hệ thống sẽ tự động trả về danh sách các tài liệu có độ liên quan cao nhất để anh/chị sử dụng.
Phân biệt cơ sở dữ liệu quan hệ và cơ sở dữ liệu vector
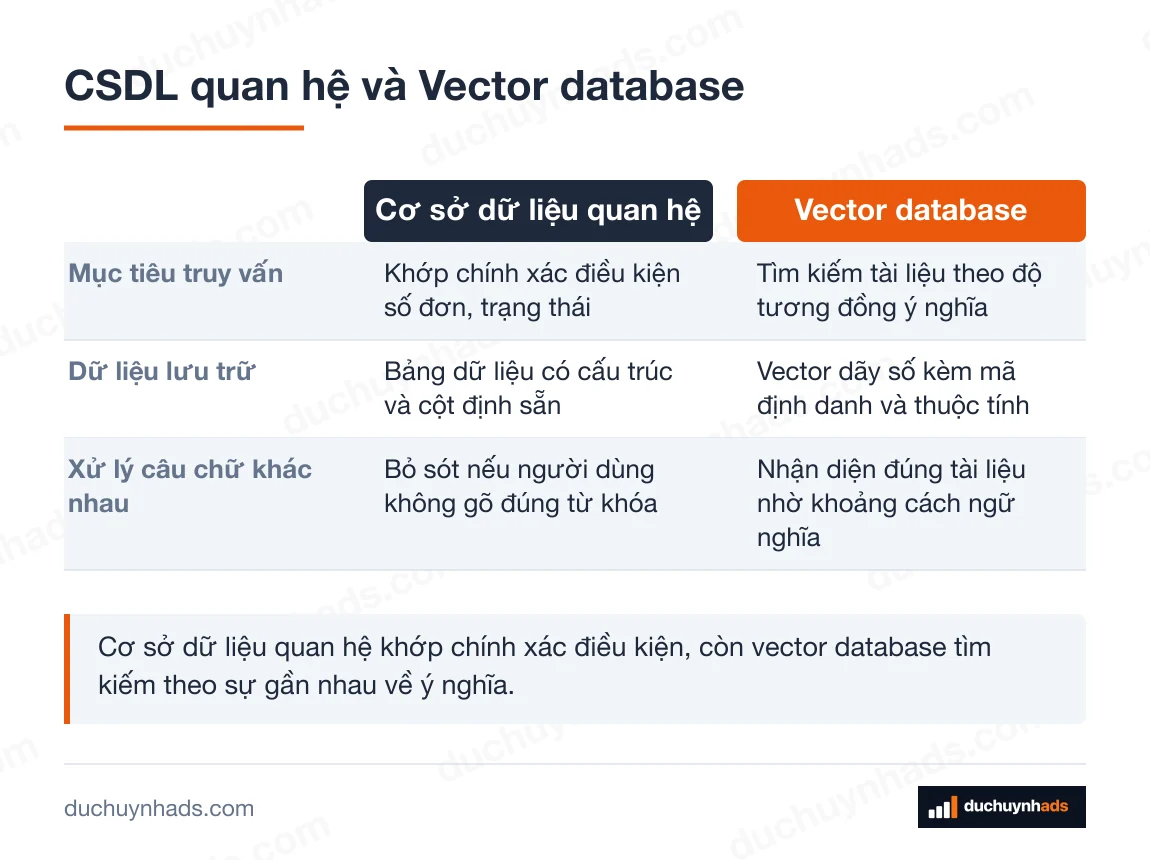
Cơ sở dữ liệu quan hệ truyền thống chuyên lưu trữ thông tin dưới dạng các bảng tính rõ ràng. Công nghệ cũ này rất xuất sắc trong việc trả lời các câu lệnh truy vấn có điều kiện cứng bằng con số hoặc chữ cái chính xác.
Ví dụ, anh/chị quản lý một shop có doanh số trên 100 triệu mỗi ngày. Khi xem báo cáo chiến dịch CPAS Facebook về Shopee trong giai đoạn 16-20/8/2026, nhóm quảng cáo hiệu quả nhất ghi nhận chi phí 5.903đ cho mỗi lượt mua. Toàn bộ chiến dịch ghi nhận 548 lượt mua với tổng giá trị chuyển đổi 32.222.984đ, giá trị trung bình mỗi đơn đạt 58.801đ và ROAS trung bình toàn chiến dịch đạt 8,54.
Số liệu thực tế từ tài khoản đang vận hành, ghi nhận tại thời điểm nêu trên. Kết quả từng shop khác nhau tuỳ ngành hàng, giá bán và ngân sách.
Những con số trên báo cáo này là dữ liệu có cấu trúc. Nếu anh/chị ra lệnh tìm “các chiến dịch có ROAS lớn hơn 8”, cơ sở dữ liệu truyền thống sẽ lướt qua cột ROAS và nhặt ra chiến dịch này ngay lập tức. Máy tính chỉ việc thực hiện một phép tính so sánh đơn giản xem số 8,54 có lớn hơn 8 hay không.
Tuy nhiên, cơ sở dữ liệu quan hệ sẽ hoàn toàn bất lực trước những câu lệnh truy vấn mang tính tự nhiên của con người. Nếu một nhân viên mới gõ câu hỏi “kênh nào đang gánh doanh thu cho shop?”, hệ thống máy chủ cũ sẽ báo lỗi lập tức. Nó không hiểu động từ “gánh” nghĩa là gì trong ngữ cảnh bán hàng. Nó cũng không biết cụm từ “gánh doanh thu” có liên quan đến cột lượt mua hay cột ROAS trong bảng.
Đây chính xác là lúc anh/chị cần đến Vector Database. Hệ thống tìm kiếm theo ý nghĩa sẽ phân tích cụm từ “gánh doanh thu” là hành động mang lại nhiều tiền nhất với mức chi phí tối ưu nhất. Nó tự động đối chiếu các tọa độ ý nghĩa và nhanh chóng tìm ra những dòng dữ liệu phản ánh hiệu suất bán hàng cao. Sự kết hợp linh hoạt giữa khả năng lọc số liệu cứng và công nghệ tìm kiếm ý nghĩa mềm này giúp anh/chị khai thác toàn bộ kho dữ liệu triệt để hơn. Xem cách các đội marketing kết nối dữ liệu và tự động hóa trong một chiến lược AI hoàn chỉnh.
Máy tính so sánh sự gần gũi của các văn bản ra sao?
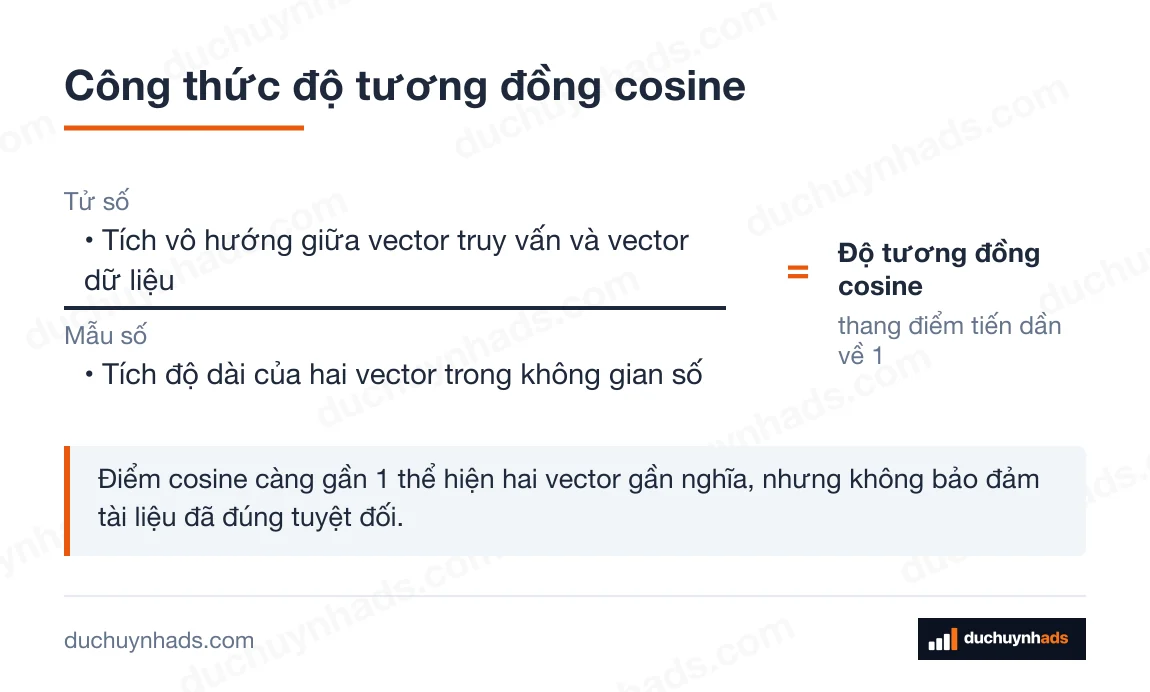
Khi các câu văn đã biến thành tọa độ không gian, hệ thống cần một cây thước chuẩn để đánh giá khoảng cách giữa chúng. Cây thước phổ biến nhất trong ngành trí tuệ nhân tạo được gọi là thuật toán “độ tương đồng cosine”. Đây là một phép toán hình học dùng để so sánh góc mở giữa hai đường thẳng nối từ vị trí tâm của không gian đến hai điểm tọa độ.
Góc giữa hai đường thẳng này càng hẹp thì độ tương đồng ý nghĩa giữa hai văn bản càng cao. Về mặt toán học, điểm số độ tương đồng cosine nằm trong khoảng từ -1 đến 1: điểm 1 thể hiện hai vector hoàn toàn cùng hướng ý nghĩa, điểm 0 thể hiện không có sự tương quan, và điểm -1 là hoàn toàn ngược hướng. Trong các bài toán xử lý văn bản thực tế, điểm số thường dao động từ 0 đến 1 nên nhiều công cụ chuẩn hóa hiển thị theo thang này. Điểm số tương đồng này giúp hệ thống dễ dàng xếp hạng hàng vạn kết quả tìm kiếm từ mức độ cao xuống mức độ thấp.
Tuy nhiên, anh/chị cần hết sức cẩn thận khi đọc điểm số toán học này. Điểm số cao chỉ chứng minh hai tọa độ đang nằm gần nhau theo cách máy tính hiểu. Nó hoàn toàn không đảm bảo câu trả lời đó sẽ hữu ích cho công việc thực tế của anh/chị. Một tài liệu hướng dẫn chung chung có thể dễ dàng đạt điểm 0,9 nhưng lại thiếu các thông tin cập nhật mới nhất. Trong khi đó, một bản báo cáo phân tích chi tiết chỉ đạt điểm 0,7 lại vô tình chứa đúng con số quan trọng mà anh/chị đang cần tìm.
Vì vậy, các kỹ sư hệ thống thường phải thiết lập một ngưỡng lọc cố định. Nếu anh/chị đặt ngưỡng quá cao (chẳng hạn như 0,95), hệ thống có nguy cơ loại bỏ mất những tài liệu rất tốt chỉ vì chúng dùng từ ngữ hơi khác biệt một chút. Nếu anh/chị đặt ngưỡng quá thấp (chẳng hạn như 0,4), kết quả trả về sẽ bị lẫn lộn chung với rất nhiều thông tin rác. Việc tìm ra một con số ngưỡng cân bằng đòi hỏi anh/chị phải thử nghiệm liên tục với các câu hỏi thực tế của người dùng nội bộ. Một kiến thức nền tảng vững chắc về LLM – tức là mô hình ngôn ngữ lớn – sẽ giúp anh/chị hiểu rõ ranh giới mong manh giữa việc máy tính tìm đúng tài liệu và việc máy tính tự sinh ra câu chữ.
Nhiều nền tảng công nghệ lớn hiện nay cũng đang ứng dụng cơ chế so sánh ý nghĩa cốt lõi này. Công cụ tìm kiếm trên mạng cũng đọc hiểu ý định thực sự của người dùng thông qua các không gian vector cực kỳ phức tạp. Anh/chị có thể tham khảo thêm tài liệu chính thức của Google Search để biết cách một cỗ máy khổng lồ xử lý hàng tỷ truy vấn mỗi ngày.
Bài học thực tiễn khi xây dựng kho tài liệu thông minh
Khi áp dụng công nghệ lưu trữ này vào thực tế vận hành, rất nhiều công ty thường gặp lỗi đẩy toàn bộ văn bản dài thành một tọa độ duy nhất. Thao tác sai lầm này làm loãng ý nghĩa của tài liệu gốc. Một bản báo cáo chiến lược dài năm trang thường chứa quá nhiều chủ đề khác nhau. Nếu gộp chung tất cả lại, vị trí của văn bản đó trong không gian số sẽ nằm ở vị trí lưng chừng. Kết quả là nó sẽ không bao giờ khớp chính xác với bất kỳ một câu hỏi chi tiết nào của nhân viên.
Cách làm đúng đắn nhất là phải chia nhỏ tài liệu ra. Anh/chị nên cắt bản báo cáo dài thành từng đoạn văn bản ngắn, đảm bảo mỗi đoạn chỉ chứa duy nhất một ý trọn vẹn. Sau đó, hệ thống sẽ tạo ra tọa độ riêng biệt cho từng đoạn văn nhỏ này. Khi người dùng hỏi về một chi tiết cụ thể, cơ sở dữ liệu sẽ dễ dàng bắt trúng đích đoạn văn chứa sẵn đáp án.
Một kinh nghiệm xương máu quan trọng khác là luôn luôn phải giữ lại lớp siêu dữ liệu (metadata). Siêu dữ liệu chính là các thẻ thông tin phụ trợ đi kèm tài liệu như ngày tháng ban hành, tên người viết, hoặc danh mục phòng ban. Vector Database xử lý ý nghĩa văn bản rất xuất sắc nhưng lại cực kỳ kém trong việc phân biệt các mốc thời gian. Nếu hai quy trình làm việc có câu chữ giống hệt nhau nhưng một bản ra đời năm 2025 và một bản cập nhật năm 2026, chúng sẽ nằm sát rạt nhau trong không gian số.
Để khắc phục triệt để vấn đề này, hệ thống cần thực hiện thao tác lọc hỗn hợp. Đầu tiên, cơ sở dữ liệu tiến hành loại bỏ tất cả các tài liệu có ngày tạo trước năm 2026 dựa trên thẻ thông tin siêu dữ liệu. Ngay sau đó, nó mới bắt đầu dùng thuật toán cosine để tìm kiếm ý nghĩa trong tập tài liệu ít ỏi còn lại. Quy trình hai bước chặt chẽ này đảm bảo anh/chị luôn nhận được tài liệu mới nhất và chính xác nhất. Sẽ không một thuật toán tiên tiến nào có thể cứu vãn nổi một kho dữ liệu lộn xộn và thiếu phân loại minh bạch ngay từ lúc ban đầu.
Câu hỏi thường gặp
Vector Database có bắt buộc khi làm chatbot không?
Hoàn toàn không bắt buộc. Nếu chatbot của anh/chị chỉ cần trả lời những câu hỏi cố định theo một kịch bản đã soạn sẵn, hệ thống lưu trữ cũ là quá đủ. Công nghệ vector này chỉ thực sự cần thiết khi chatbot bắt buộc phải đọc hàng nghìn trang tài liệu nội bộ để tự mình tìm ra câu trả lời mới mỗi ngày.
Có thể lưu hình ảnh vào cơ sở dữ liệu vector không?
Hoàn toàn có thể. Các mô hình trí tuệ nhân tạo hiện đại ngày nay đều có khả năng chuyển đổi cả hình ảnh thành những dãy số tọa độ. Nhờ tính năng này, anh/chị có thể tải một bức ảnh lên hệ thống và yêu cầu nó tự động tìm ra những sản phẩm có kiểu dáng hoặc màu sắc tương tự đang nằm trong kho hàng.
Kho dữ liệu truyền thống có bị thay thế hoàn toàn không?
Công nghệ vector hoàn toàn không sinh ra để tiêu diệt cơ sở dữ liệu quan hệ. Chúng được thiết kế để tồn tại song song và hỗ trợ đắc lực lẫn nhau. Kho dữ liệu cũ vẫn chịu trách nhiệm chính trong việc lưu trữ mã sản phẩm, mức giá bán, hoặc số lượng hàng tồn kho. Kho vector sẽ chỉ lo phần tìm kiếm ý nghĩa và kết nối các đoạn thông tin lại với nhau.
Người không biết lập trình có tự cài đặt được hệ thống này không?
Hiện nay thị trường có rất nhiều nền tảng cung cấp dịch vụ lưu trữ vector được đóng gói sẵn trên môi trường đám mây. Anh/chị chỉ việc tạo một tài khoản và đẩy tài liệu lên thông qua giao diện kéo thả chuột đơn giản. Toàn bộ các thao tác phức tạp như biến chữ thành số và lập chỉ mục đều được máy chủ tự động xử lý ngầm.
Làm sao để biết hệ thống đang trả về kết quả chính xác?
Cách duy nhất và đáng tin cậy nhất là tạo ra một danh sách các câu hỏi thử nghiệm thực tế. Anh/chị cần ghi chép lại toàn bộ những câu hỏi mà nhân viên của mình hay thắc mắc nhất. Sau đó, anh/chị nhập trực tiếp chúng vào hệ thống mới, tự mình đọc kết quả và đánh giá chéo. Việc đo lường độ hiệu quả luôn phải dựa trên trải nghiệm của người dùng cuối, không phải dựa trên điểm số toán học khô khan của máy tính.